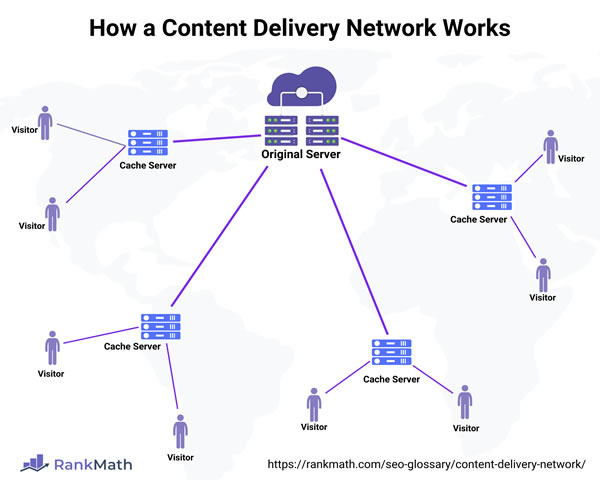
西部数码高防cdn通常在检测到异常流量后触发多级响应机制。第一步由监控平台自动识别并启动流量清洗,第二步将流量导向清洗节点并下发策略,第三步是人工运维介入进行策略优化和回溯分析。作为运维,应关注检测灵敏度、白名单/黑名单的更新频率以及与客户的联动通道是否畅通。
应核查包括流量峰值、清洗命中率、源IP分布、链路丢包率和回源压力等关键指标。通过实时面板和日志采集快速定位异常点,必要时要求对方开放更详细的免打扰通道以便快速调整清洗规则。
1)确认告警来源并复核阈值;2)启用临时策略并监测效果;3)在清洗有效时逐步放开受限服务;4)记录处置过程供事后复盘。
避免频繁切换策略导致回源抖动,保留完整的时间序列日志用于事后分析。
应急响应时效可分为自动化响应时间、人工确认时间与问题闭环时间三部分。理想状态下自动响应在数秒级,人工确认在数分钟到十分钟级,完整闭环(含根因定位和修复)应在数小时内完成。运维应关注SLA条款中的响应承诺并在事件中做时间线记录。
建立专属联系人、预置应急策略模板、保持技术联系人24/7可达并定期演练。演练能显著缩短人工确认与处置时间。
使用自动化脚本下发规则、预定义流量异常的自动化策略,以及与运营商/清洗节点的直连通道。
确保自动化规则具备回退机制,防止误杀正常业务流量。
良好的技术支持服务质量要求提供完整的请求链路日志、清洗节点日志、流量样本和告警时间线。运维应检查日志粒度、保存周期与导出接口,确认是否支持按时间段、按IP段和按业务维度筛选。
判断标准是能否从日志中复现异常、追溯来源、分析规则命中情况并验证回源影响。若缺失关键字段,应要求对方补充或开通更高权限的审计日志。
提前申请API导出权限、建立定期拉取机制并同步到本地SIEM以便快速检索。
注意保护日志中的敏感信息,并遵循合规存储周期。
评估维度包括可用性(Uptime)、响应延迟、清洗节点吞吐能力及回源稳定性。通过长期监测、压测与故障注入演练可以得到较全面的结论。运维应与对方约定定期的性能报告并保留历史数据用于趋势分析。
常用指标有HTTP 5xx/4xx率、平均响应时延(P95/P99)、流量峰值处理能力与清洗误杀率等。
结合真实流量回放、压测和定期演练以验证在高并发与异常流量下的可用性。
压测前务必告知服务商并在低峰期执行,避免影响生产环境。
良好的合作包括建立专属沟通渠道、定期联席会议、共享应急演练结果和共建知识库。运维应主动提供业务拓展与流量模型变化,便于服务商提前优化清洗策略与容量计划,从而提升整体技术支持服务质量。
制定联合SOP、共享监控面板和设置定期技术回顾会议,形成闭环改进流程。
基于事件复盘持续调整阈值与规则、扩展清洗能力并优化回源配置以减少误杀与回源压力。
确保双方责任与权限清晰,以提高协作效率并降低沟通成本。