问题一:运营方应监控哪些关键指标来衡量推送CDN的质量?
要判断推送到CDN的质量,核心在于覆盖从推流端到观众端的可观测性。常用的关键指标包括:推流带宽、上行丢包率、编码帧率/关键帧间隔、首帧时延(First Frame)、播放启动时延、端到端延迟、CDN上行/下行错误率、转发抖动(RTP jitter)和观众侧的卡顿率与播放成功率。
指标分层说明
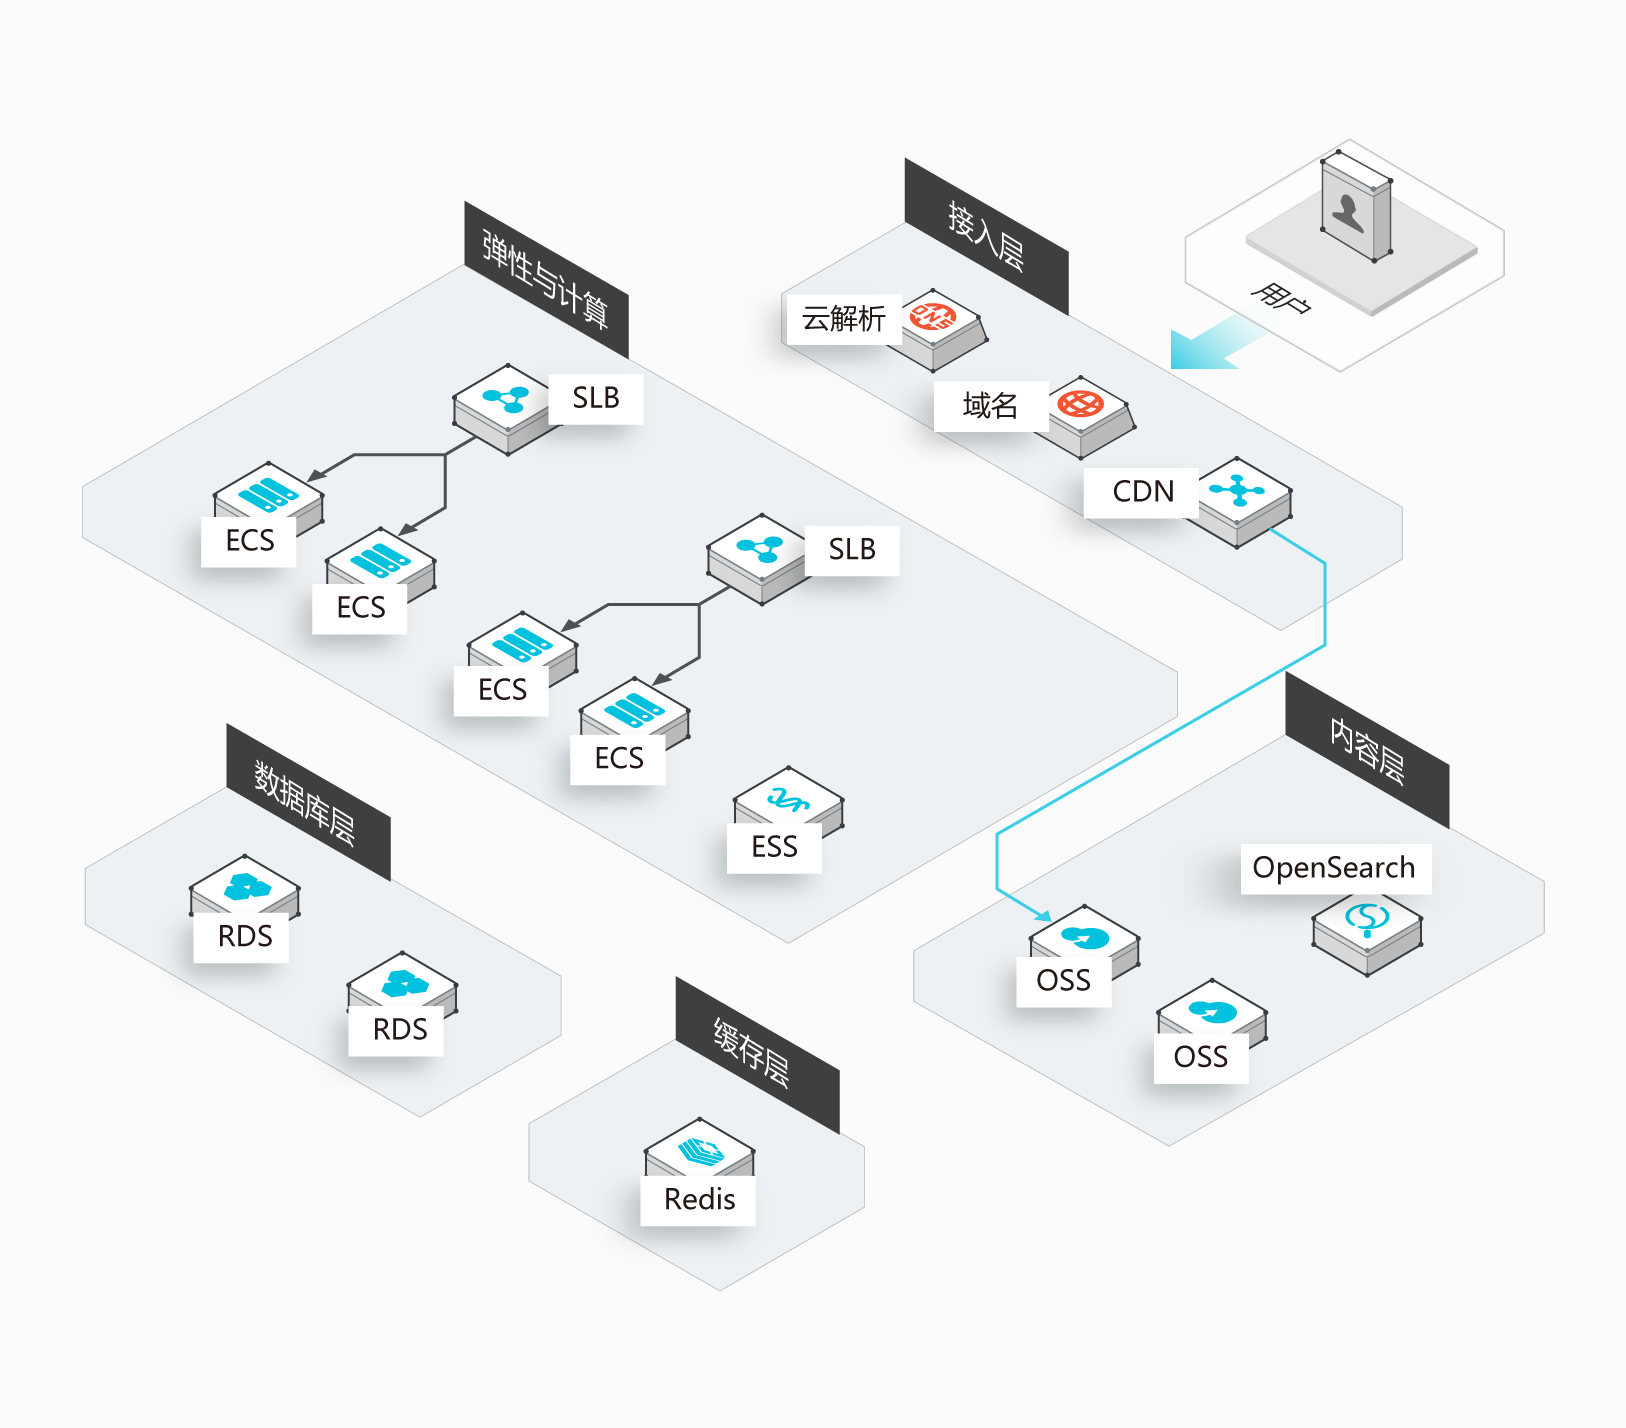
将指标分为三层:推流层(采集带宽、上行丢包)、CDN传输层(节点丢包、转发延时、缓存命中)、播放层(首帧、卡顿、播放失败)。通过分层聚合能快速缩小问题范围。
为何这些指标重要
例如,持续高上行丢包意味着推流端网络问题;而CDN节点丢包或高抖动则提示传输链路或CDN健康问题;观众大量卡顿但CDN指标正常,可能是下游网络或播放器问题。
关键字提示
在监控面板上突出显示:丢包、延时、卡顿、首帧等词汇,便于运维快速识别。
问题二:如何实时采集推送端和CDN侧的数据?
实时采集数据需要在推流端、CDN和播放器埋点三处同时部署采集能力。推流端侧通过SDK/采集程序上报RTCP/Stats、带宽与编码信息;CDN侧通过接入链路探针、节点日志、流量汇总和链路监测采集转发延时、错误率和QPS;观众侧通过播放器埋点上报首帧时长、缓冲事件、网络状态。
实时上报与上游聚合
采用轻量的上报协议(例如HTTP/2或gRPC)以及批量/采样策略,送入实时处理平台(如Kafka + 流处理),在1~10秒级完成指标聚合与展现。
数据一致性与打点规范
统一时间戳、会话ID和流ID,确保不同来源的数据可以关联。使用序列化格式并保留原始日志以便回溯。
性能考虑
避免在推流端做过多阻塞性上报,建议异步缓存并按窗口批量发送以降低对推流吞吐的影响。
问题三:观众体验下降时如何快速定位是推流端、CDN还是下游网络问题?
定位流程应遵循“分层排除法”:先看观众侧埋点再看CDN再看推流端。具体步骤:查看观众埋点的播放错误/卡顿时间线,若大部分观众在同一时间段出现问题且分布在同一CDN节点或同一路由,则优先怀疑CDN或上游网络。
排查步骤
1) 对比观众地域与所用CDN节点;2) 检查CDN节点健康与上行链路指标(丢包/延时);3) 查看推流端上行状态(丢包、编码丢帧);4) 回放推流或抓包分析RTMP/RTSP/RTP包丢失与重传。
快速定位技巧
利用采样回放(见下一问题)与链路追踪ID可以将问题范围缩小到某个节点或某个运营商。若问题仅限少数用户,重点关注用户网络类型和终端日志。
案例提示
例如:大量用户卡顿但CDN上行正常且推流端稳定,通常是下游传输(最后一公里)或ISP侧问题,可要求观测ISP路由或建议用户切换网络。
问题四:是否可以通过用户侧埋点与采样回放快速复现问题?
可以。播放器埋点记录关键事件(首帧、卡顿、错误码)并携带关键网络快照(RTT、下载速度、缓冲队列长度)上报,同时在服务端对异常流进行自动采样并保存小段原始流作为回放素材。
回放与离线分析流程
当监控发现异常时,触发回放请求:从CDN或推流端抓取对应时间窗口的原始TS/FLV片段,放入隔离环境或工具中复现,结合播放端日志可以还原用户真实体验。
埋点设计要点
保证埋点轻量(关键字段、小频率),并包含链路ID与时间戳,以便快速关联推流、CDN与观众侧数据。
注意隐私与存储成本
回放文件需做脱敏策略与生命周期管理,采样率也应在成本和排查效率之间折中。
问题五:建立告警与自动化诊断机制有哪些实践建议?
告警要做到“精确、分级、可动作”。针对不同指标设定多级阈值(警告/严重),并结合聚合规则(比如多个地区同时异常触发高优先级告警)。同时自动化诊断脚本应在告警触发后自动拉取相关日志、抓包、执行回放或运行链路健康检查。
自动化诊断要素
自动化流程包含:指标聚合→异常判定→上下游数据拉取→初步定位结论(推流/CDN/下游)→生成工单并推送给相应团队。要支持人工复核与补充调查。
告警抑制与避噪
引入抑制规则(维护窗口、已知问题)和自学习阈值(基于历史波动)以降低误报率,保证运维关注真正影响观众体验的问题。
团队协作与演练
定期演练链路故障应对,明确责任人和SLA,保证发现问题后能在最短时间内完成定位与恢复。